NVIDIA 생태계에 들어온 AI 추론칩: d-Matrix Raptor와 NVLink Fusion이 바꾸는 AI 서버 구조
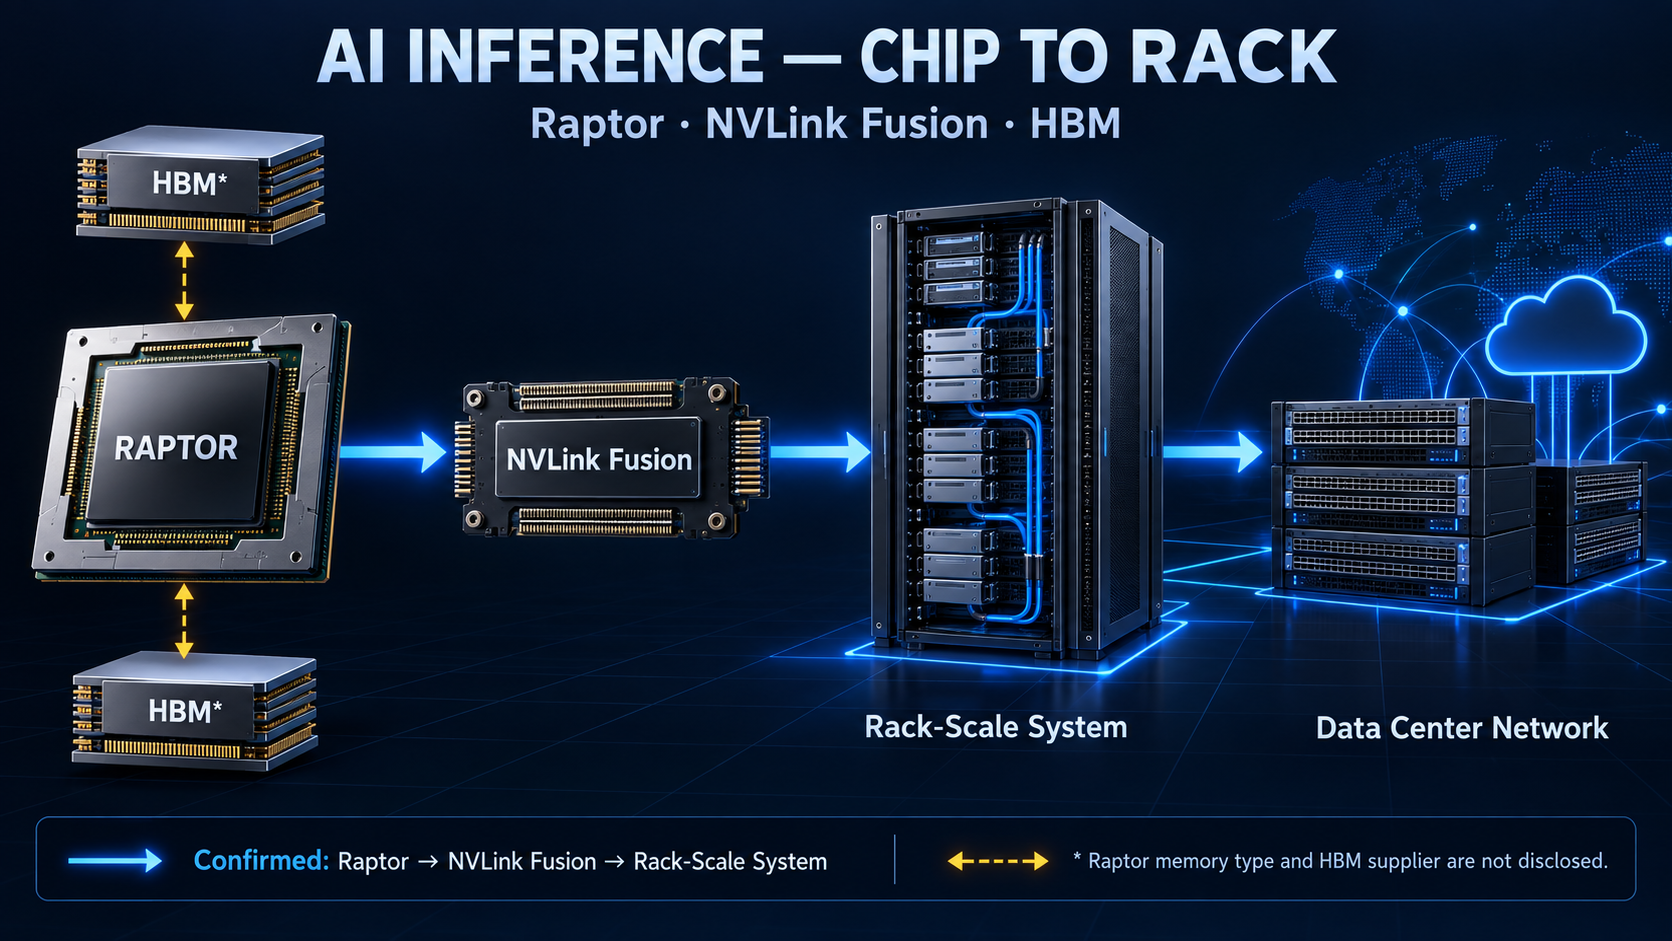
d-Matrix는 차세대 추론 가속기 Raptor를 NVIDIA의 NVLink Fusion 기반 서버에 통합할 계획이다. 이는 외부 AI 칩도 NVIDIA의 랙·네트워크 생태계 안에서 GPU와 결합할 수 있다는 의미다. 국내에서는 아직 Raptor 직접 공급사가 확인되지 않았으며, SK하이닉스·삼성전자와 후공정·테스트 기업은 AI 추론 및 고성능 메모리 시장 확대에 따른 조건부 수혜 후보로 봐야 한다.
AI 반도체 경쟁의 다음 전장은 ‘추론’
생성형 AI 산업의 초기 경쟁은 더 큰 모델을 만드는 학습 성능에 집중됐다. 그러나 챗봇, 코딩 도우미, 음성 에이전트처럼 실제 사용자가 반복적으로 호출하는 서비스가 늘면서 경쟁의 무게중심은 모델을 만드는 과정에서 만든 모델을 경제적으로 운영하는 과정으로 이동하고 있다.
이 운영 단계가 바로 AI 추론(inference)이다. d-Matrix는 Raptor의 최종 설계를 2026년 말까지 완료하고, 이를 탑재한 NVIDIA 호환 랙 시스템을 2027년에 공급한다는 목표를 제시했다. 다만 계약 규모와 최종 고객, 세부 성능은 공개되지 않았다.
Raptor와 NVLink Fusion은 어떻게 작동하는가
1. 학습과 추론의 차이
AI 학습은 방대한 데이터를 이용해 모델의 가중치를 계산하는 과정이다. 반면 추론은 학습된 모델이 사용자의 요청에 답변·이미지·음성을 생성하는 과정이다. 추론 시스템에서는 최고 연산성능뿐 아니라 다음 지표가 중요하다.
- 첫 응답까지 걸리는 지연시간
- 초당 토큰 처리량과 동시 사용자 수
- 메모리 용량과 대역폭
- 토큰당 전력소비와 총운영비용
2. d-Matrix Raptor의 역할
d-Matrix는 범용 GPU와 달리 실시간 AI 추론에 특화된 가속기를 개발한다. 추론 과정에서는 모델 가중치와 중간 데이터를 메모리와 연산장치 사이에서 계속 이동시키기 때문에 연산성능이 충분해도 데이터 공급이 늦으면 성능이 떨어진다. Raptor의 경쟁력은 결국 이러한 메모리 병목을 얼마나 낮은 전력과 비용으로 완화하는지에 달려 있다.
현재 Raptor의 세부 연산성능, 소비전력, 메모리 종류와 공급사는 공개되지 않았다.
3. NVLink Fusion의 의미
NVLink는 CPU, GPU, 메모리와 가속기 사이에서 대량의 데이터를 빠르게 전달하는 NVIDIA의 고속 인터커넥트다. NVLink Fusion은 외부 기업이 설계한 맞춤형 CPU나 가속기를 이 연결 생태계에 통합할 수 있도록 확장한 플랫폼이다.
Astera Labs는 시스템 내부의 맞춤형 고속 데이터 경로 개발에 참여한다. 이 구조가 상용화되면 가속기 스타트업은 서버·네트워크 생태계를 처음부터 전부 구축해야 하는 부담을 줄일 수 있다.
무엇이 달라지는가
- d-Matrix는 Raptor에 NVLink Fusion을 적용한다.
- Raptor 최종 설계 목표는 2026년 말, 시스템 공급 목표는 2027년이다.
- 챗봇·코딩 도우미·음성 에이전트와 같은 저지연 추론 서비스를 겨냥한다.
- Astera Labs가 고속 데이터 연결 솔루션 개발에 참여한다.
- 성능, 소비전력, 계약 규모와 상용 고객은 아직 공개되지 않았다.
기술적으로 가장 중요한 변화는 경쟁 단위가 개별 칩에서 랙 전체로 확대된다는 점이다. NVIDIA는 외부 ASIC을 배제하지 않고 자사 인터커넥트와 랙 규격 안으로 편입함으로써 플랫폼 영향력을 유지할 수 있다. d-Matrix는 기존 NVIDIA 기반 인프라와 연결되는 경로를 확보해 상용화 장벽을 낮출 가능성이 있다.
산업과 기업에 미치는 영향
NVIDIA: 경쟁 칩도 생태계 확장의 도구가 된다
맞춤형 ASIC이 일부 GPU 추론 수요를 대체하더라도 NVLink Fusion을 선택한다면 NVIDIA는 인터커넥트, 스위치, 네트워크와 시스템 소프트웨어 영역에서 영향력을 유지할 수 있다. NVIDIA가 개별 GPU 공급자를 넘어 AI 데이터센터의 시스템 규격을 주도하려는 전략으로 해석할 수 있다.
d-Matrix: 칩 성능만큼 상용화 능력이 중요하다
고객은 기존 NVIDIA 인프라를 전부 교체하지 않고도 특화 가속기를 도입할 가능성이 생긴다. 그러나 실제 가치는 2027년 양산 일정, 서버 인증, 소프트웨어 호환성과 고객 확보 여부로 검증돼야 한다.
Astera Labs: 연결 병목이 사업 기회가 된다
고밀도 AI 랙에서는 CPU, 가속기, 메모리, 네트워크 카드와 스위치 사이의 데이터 흐름이 중요하다. 프로세서 성능과 전력밀도가 높아질수록 신호 무결성, 연결 지연과 발열 문제가 커지므로 고속 인터커넥트 반도체의 중요성도 함께 높아진다.
국내 반도체 수혜기업 분석
현재 공개된 자료만으로는 Raptor의 HBM·DRAM 공급사, 파운드리와 패키징 업체가 확인되지 않았다. 아래 기업들은 Raptor 직접 공급사가 아니라 AI 추론·고성능 메모리 시장이 확대될 때 연결될 수 있는 조건부 또는 산업 확장 수혜 후보다.
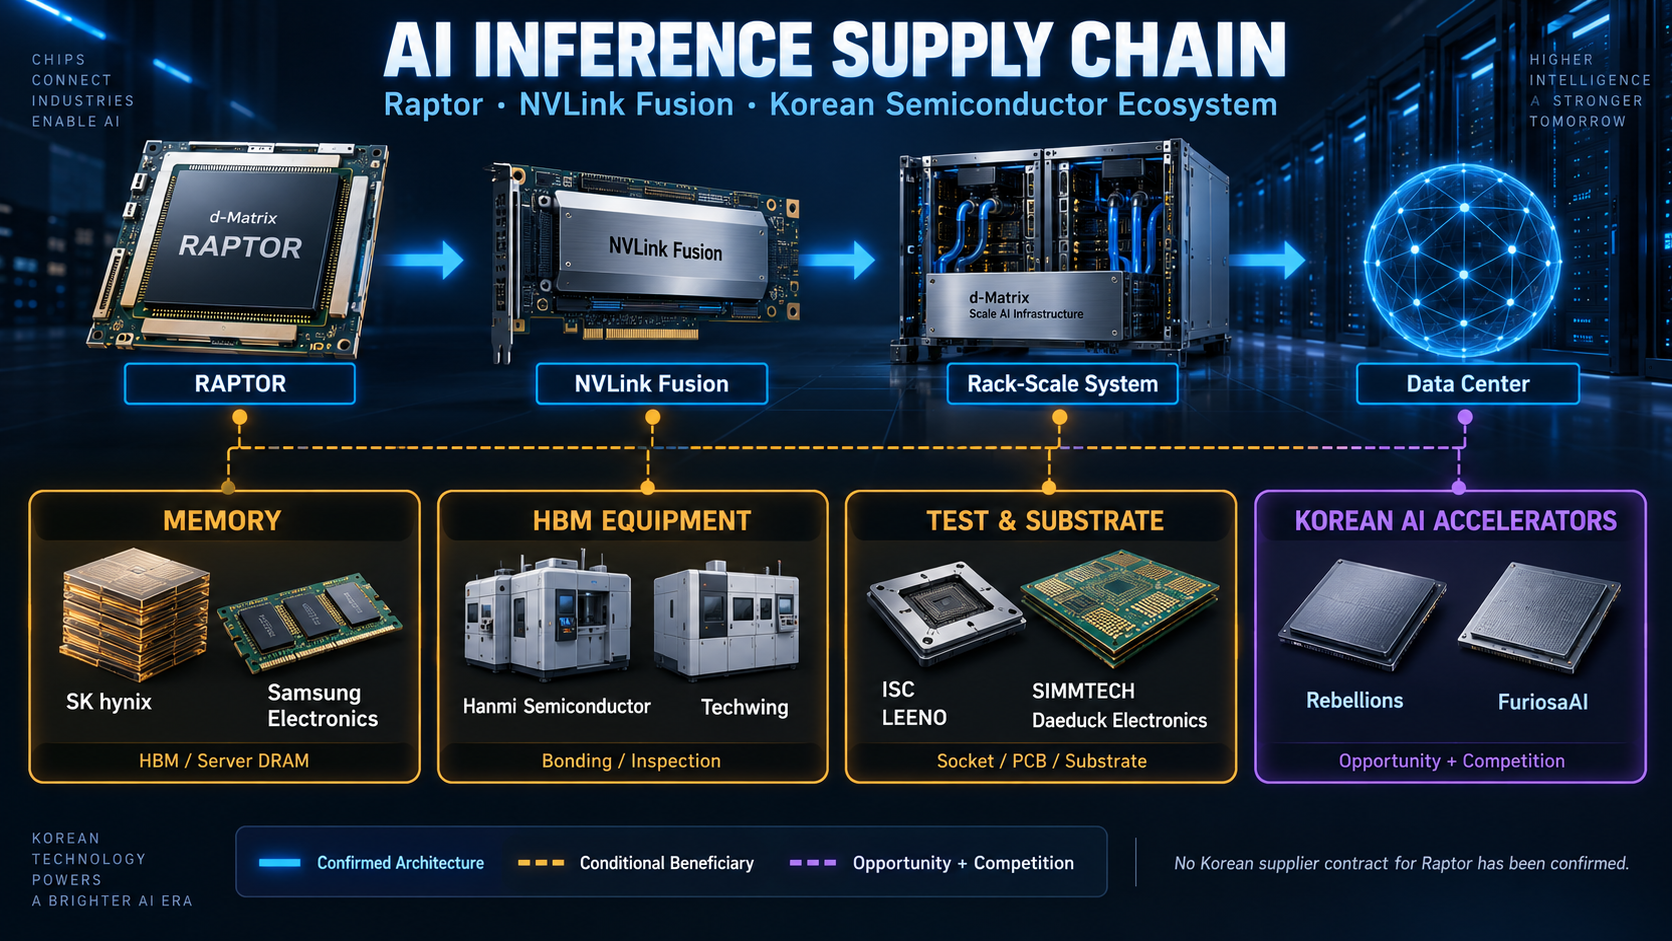
| 기업 | 관련 영역 | 판단 | 수혜 현실화 조건 | 핵심 위험 |
|---|---|---|---|---|
| SK하이닉스 | HBM4·서버 DRAM | 조건부 중상 | Raptor 또는 NVLink Fusion 가속기에 메모리 채택 | Raptor 메모리 구조·공급사 미공개 |
| 삼성전자 | HBM·DDR5·파운드리·패키징 | 조건부 중상 | 메모리 공급 또는 생산·패키징 참여 | 고객 인증과 계약 확인 필요 |
| 한미반도체 | HBM 적층 장비 | 간접 중간 | HBM 채택 가속기 증가와 설비투자 확대 | Raptor 프로젝트와 직접 연결 없음 |
| 테크윙 | HBM 검사·테스트 장비 | 간접 중간 | HBM 검사공정 투자 증가 | 고객사 CAPEX 시점에 따른 변동 |
| ISC·리노공업 | 테스트 소켓·핀 | 간접 중간 | AI 가속기 개발·양산 테스트 확대 | Raptor용 공급 여부 미확인 |
| 심텍·대덕전자 | 고다층 PCB·반도체 기판 | 장기 중하 | 고속·고밀도 AI 서버용 기판 수요 증가 | 제품별 고객·수익성 차이 |
| 리벨리온·퓨리오사AI | 국내 AI 추론 가속기 | 기회·위협 공존 | NVLink 생태계 참여 또는 호환성 확보 | d-Matrix와 글로벌 고객을 두고 경쟁 |
1. SK하이닉스: 가장 유력하지만 확정 수혜는 아니다
대규모 추론에서도 모델 가중치와 KV 캐시를 빠르게 처리하려면 대용량·고대역폭 메모리가 중요하다. Raptor가 HBM 기반 구조를 채택한다면 SK하이닉스는 국내에서 가장 먼저 연결될 수 있는 기업이다. SK하이닉스는 HBM4 개발을 완료하고 양산 준비를 공식화한 바 있다.
그러나 Raptor가 HBM을 사용하는지, 어떤 세대와 용량을 채택하는지, 어느 회사 제품을 공급받는지는 알려지지 않았다. 따라서 현 단계에서는 Raptor 직접 수혜가 아니라 AI 추론용 고성능 메모리 시장 확대 수혜로 표현하는 것이 정확하다.
2. 삼성전자: 메모리와 제조를 함께 볼 수 있는 후보
삼성전자는 HBM과 서버 DRAM, 첨단 파운드리와 패키징 사업을 함께 보유한다. 이론적으로는 Raptor용 메모리 공급, 가속기 생산 또는 첨단 패키징 참여라는 세 가지 경로가 존재한다. 다만 d-Matrix가 공급망을 공개하지 않았기 때문에 삼성전자의 참여를 단정할 근거는 없다.
3. 한미반도체·테크윙: HBM CAPEX의 간접 수혜
개별 Raptor의 성공보다 더 중요한 것은 GPU 외에 ASIC과 추론 전용칩까지 고성능 메모리를 채택하는 흐름이다. HBM 수요가 늘면 메모리 제조사의 적층·검사 설비투자가 확대될 수 있다. 한미반도체와 테크윙은 이 설비투자 경로에서 관찰할 기업이지만 Raptor 공급망에 직접 포함됐다는 의미는 아니다.
4. ISC·리노공업: 가속기 다양화가 테스트 수요를 키운다
NVLink Fusion 참여 칩이 늘어나면 개발·양산 단계에서 검증할 고성능 반도체도 증가한다. AI 칩은 높은 데이터 속도와 전력밀도로 인해 테스트 인터페이스의 기술적 난도가 높다. ISC와 리노공업은 이러한 구조적 테스트 수요와 연결될 수 있으나 개별 고객 관계는 별도로 확인해야 한다.
5. 리벨리온·퓨리오사AI: 잠재 수혜주이자 경쟁자
d-Matrix가 NVIDIA 생태계를 활용해 시장 진입 속도를 높인다면 독립적인 서버·소프트웨어 체계를 구축하는 국내 AI 반도체 기업에는 경쟁 압력이 될 수 있다. 반대로 국내 가속기 기업이 향후 NVLink Fusion에 참여한다면 기존 NVIDIA 데이터센터와의 연결성, 글로벌 고객 접근성과 시스템 인증 측면에서 기회를 얻을 수 있다.
엔지니어 관점의 핵심 쟁점
- 랙 전체 성능: FLOPS만이 아니라 메모리 대역폭, 인터커넥트 지연과 통신 병목을 함께 봐야 한다.
- 소프트웨어 호환성: 물리적 연결 이후에도 컴파일러, 연산 라이브러리와 모델 변환 도구가 안정적으로 작동해야 한다.
- 열·기계적 신뢰성: 고밀도 패키지에서는 열팽창 차이, 인터포저 변형, 접합부 피로와 액체냉각 인터페이스가 중요하다.
- 추론 경제성: 칩 최고 성능보다 실제 가동률을 반영한 토큰당 총비용이 상업성을 결정한다.
- 플랫폼 종속성: NVLink 생태계 진입은 상용화를 돕는 동시에 NVIDIA 규격 의존도를 높일 수 있다.
향후 관전 포인트
- 2026년 말 Raptor 최종 설계 일정 준수 여부
- 2027년 랙 시스템 출시와 서버 인증 진행 상황
- 초당 토큰 수, 첫 토큰 응답시간과 전력효율 공개
- 클라우드·AI 서비스 기업의 실제 도입 계약
- Raptor의 메모리, 파운드리와 패키징 공급사
- 국내 AI 가속기 기업의 NVLink Fusion 참여 여부
결론
d-Matrix Raptor와 NVLink Fusion의 결합은 AI 반도체 경쟁이 개별 칩에서 메모리, 인터커넥트, 네트워크와 소프트웨어를 통합한 랙 스케일 경쟁으로 이동하고 있음을 보여준다. NVIDIA는 외부 가속기를 수용하면서도 연결 규격과 플랫폼의 주도권을 유지하고, d-Matrix는 상용화 장벽을 낮출 기회를 얻는다.
국내에서는 Raptor 직접 공급사가 아직 확인되지 않았다. SK하이닉스와 삼성전자는 메모리·제조 분야의 조건부 후보이며, 한미반도체·테크윙·ISC·리노공업 등은 AI 가속기와 HBM 시장 확대에 따른 간접 수혜 관점에서 살펴볼 수 있다. 최종 판단은 Raptor의 부품 구성과 실제 공급계약이 공개된 뒤 내려야 한다.
참고자료
Reuters, “Chip startup d-Matrix to use Nvidia chip-linking tech in AI servers,” 2026-09-10
Reuters, “SK hynix says readying HBM4 production after completing internal certification,” 2025-09-12
'FUTURE' 카테고리의 다른 글
| 현대차 자체 자율주행 2029년으로 연기: NVIDIA Hyperion 10과 Atria 이중 전략 분석 (0) | 2026.09.14 |
|---|---|
| [AUTOMOTIVE DEEP TECH 01] 자동차는 왜 ‘바퀴 달린 AI 데이터센터’가 되었나? (0) | 2026.09.11 |
| NVIDIA 호주 2GW AI 팩토리 구축: GPU보다 전력·냉각·네트워크가 중요한 이유 (0) | 2026.09.10 |
| 아이폰 듀오 vs 갤럭시 Z 폴드8, 특허전쟁 가능성은? 힌지·OLED·디자인권 분석 (0) | 2026.09.10 |
| 휴머노이드도 자동차처럼 만든다: XPENG IRON 생산라인이 연 ‘로봇 양산공학’ 경쟁 (0) | 2026.09.09 |


